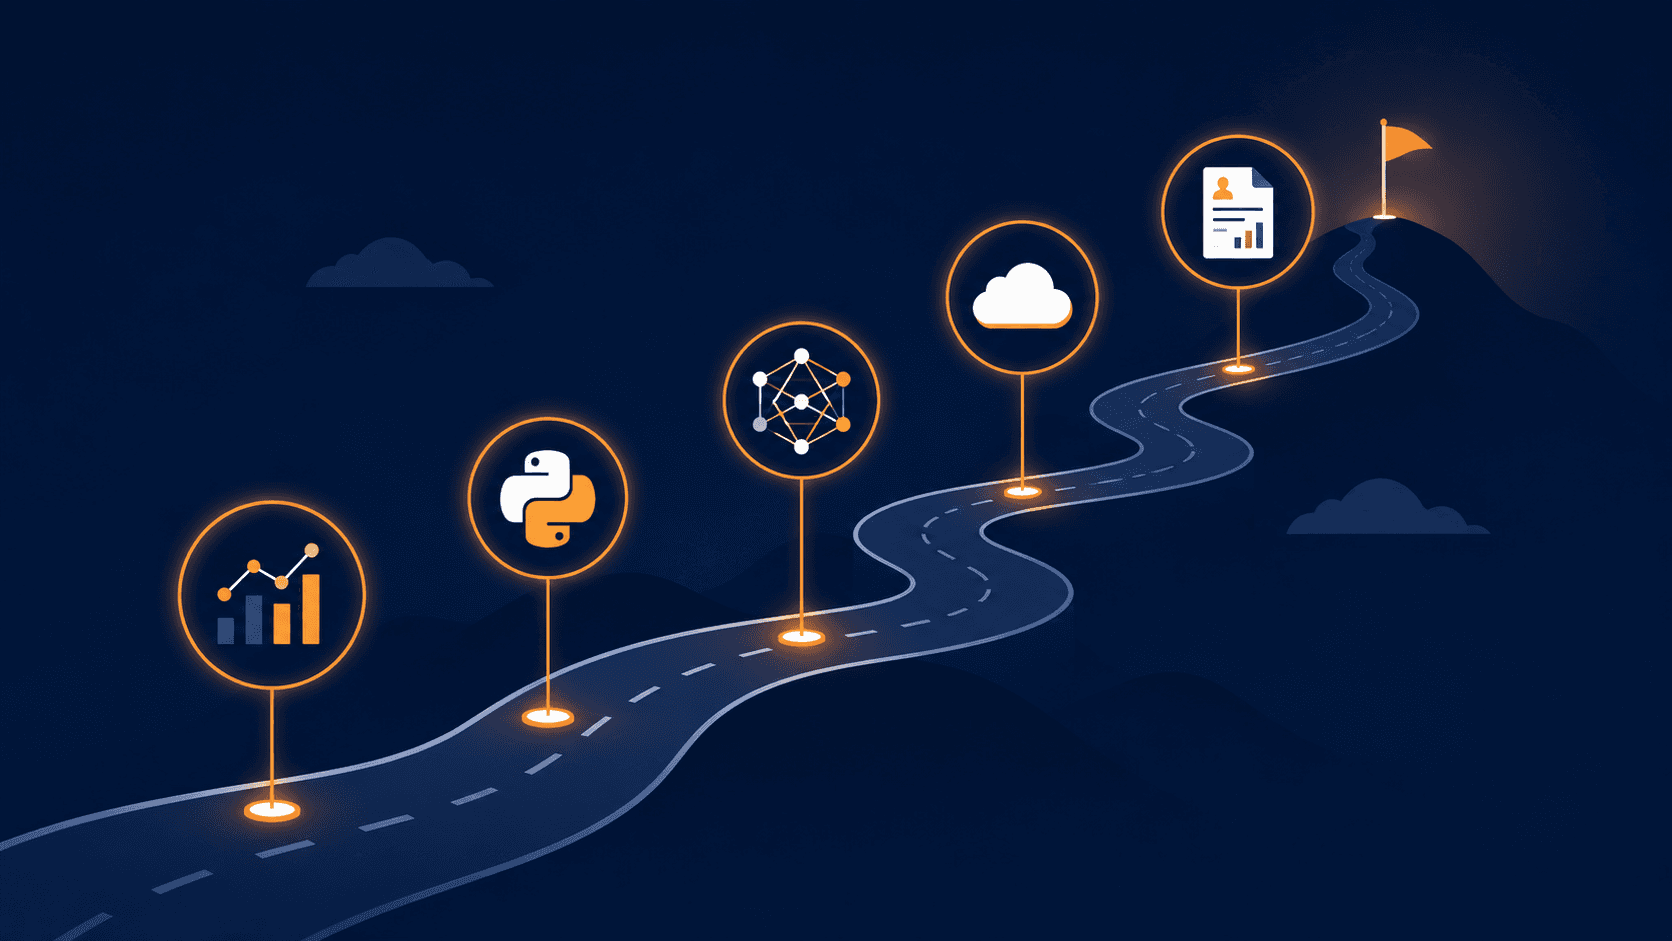
Une roadmap Data Science est un parcours structuré qui vous guide de zéro jusqu’aux compétences avancées — statistiques, Python, R, SQL, machine learning, deep learning, outillage, Git et portfolio — avec une progression logique pour éviter la dispersion et progresser efficacement. Cette version 2026 intègre ce qui a réellement changé depuis un an : Python 3.14 et 3.15, l’outillage qui rend un profil junior employable, le MLOps, l’évaluation des LLM et le cadre légal de l’IA.
Pourquoi une roadmap est essentielle en 2026 ?
La Data Science est un domaine aussi passionnant que vaste. En 2026, on ne parle plus seulement d’analyse de données : il faut jongler avec des notions de statistiques, de programmation, d’apprentissage automatique, de cloud… Le tout, avec des outils qui évoluent sans cesse — et l’émergence de l’IA générative qui redessine les contours du métier.
Face à cette complexité, on peut vite se sentir perdu·e. Par où commencer ? Quoi apprendre ? Dans quel ordre ?
C’est là qu’intervient une roadmap. C’est votre boussole. Elle vous montre le chemin, vous permet de structurer votre apprentissage, d’éviter la dispersion… et de garder la motivation sur la durée.
Une précision sur ce que cette feuille de route n’est pas : un programme officiel. C’est le parcours que je recommande à mes apprenants, nourri de mon expérience de formatrice. Les durées que je cite plus bas sont des ordres de grandeur observés sur des promotions, pas des garanties — votre rythme dépendra de votre disponibilité et de vos acquis.
Astuce — Ne cherchez pas à tout comprendre d’un coup. Avancez une étape à la fois. Mieux vaut bien maîtriser les bases que de vouloir tout survoler.
Dans les chapitres qui suivent, je vous guide à travers cinq grandes étapes pour construire des bases solides et progresser vers des compétences avancées.
Étape 1 – Les bases indispensables
Statistiques : la fondation de toute analyse
Avant de faire tourner des algorithmes complexes, vous devez comprendre comment les données se comportent. Les statistiques sont incontournables — pas de panique, on parle ici de concepts simples, utiles et concrets.
Objectif de cette partie — être capable de :
- Comprendre les grandes tendances d’un jeu de données.
- Interpréter des chiffres avec bon sens.
- Évaluer si un résultat est fiable ou juste dû au hasard.
Les concepts à découvrir :
- Moyenne : la valeur « centrale ». Exemple : 5 personnes d’âges 20, 25, 27, 30, 35 → moyenne = 27,4 ans.
- Variance et écart-type : indiquent si vos données sont regroupées autour de la moyenne ou très dispersées.
- Régression linéaire simple : prédire le prix d’un appartement en fonction de sa surface — cas typique de régression.
- Tests d’hypothèses : comparer deux groupes et vérifier si la différence observée est statistiquement significative ou due au hasard.
Exemple concret — vous analysez les résultats d’un sondage sur les habitudes sportives. Grâce aux statistiques, vous pouvez calculer l’âge moyen des participants, comparer les pratiques selon le genre, et tester si les différences observées sont fiables.
Conseil de pro — Vous n’avez pas besoin d’apprendre par cœur toutes les formules. L’essentiel, c’est de comprendre l’intuition derrière chaque notion. Les outils comme Python ou R feront les calculs — mais vous devez savoir ce que ces chiffres signifient.
Python & R : vos deux langages compagnons
Choisir entre Python et R peut sembler compliqué. En réalité, ces deux langages sont complémentaires. Commencez par l’un, apprenez l’autre plus tard si besoin. Si vous hésitez, consultez mon article comparatif Python vs R pour choisir selon votre profil.
Mes deux formations vidéo de 8h sur Udemy pour acquérir des bases solides : R pour la Data Science et Python pour la Data Science.
Python : polyvalent et incontournable — Python est aujourd’hui le langage le plus utilisé en Data Science. Il est simple à lire même pour un débutant, ultra flexible (analyse, machine learning, web, IA générative), et soutenu par une communauté immense. En 2026, il s’impose aussi comme le langage de référence pour interagir avec les APIs des grands modèles de langage actuels — Claude, GPT-5, Mistral…
Exemple — Vous voulez nettoyer un fichier Excel avec des données clients, puis créer un graphique ? En Python, vous pouvez le faire en quelques lignes avec
pandasetmatplotlib.
R : le langage des statistiques — R est particulièrement apprécié des chercheurs, universitaires et statisticiens. Il excelle dans les analyses statistiques complexes, les visualisations de qualité avec ggplot2, et les documents reproductibles.
Sur ce dernier point, une mise à jour utile si vous aviez l’habitude de R Markdown : Quarto est le successeur recommandé. Il reprend les principes du document reproductible en devenant langage-agnostique — vous écrivez la même syntaxe pour R, Python, Julia ou Observable. R Markdown n’est pas déprécié et reste pris en charge, mais il ne reçoit plus d’initiatives de fonctionnalités majeures : c’est vers Quarto que se fait le développement [17] [18].
Exemple — Vous réalisez une étude sur les corrélations entre variables dans un sondage ? R vous donne tous les outils pour explorer, tester et visualiser facilement.
Conseil de pro — Commencez par Python si vous voulez une base solide, moderne et polyvalente. Si vous êtes plus attiré·e par les statistiques ou la recherche, R peut aussi être un bon point de départ. L’essentiel : écrire du code régulièrement.
Python 3.14 et 3.15 : ce qui change en 2026
Une roadmap qui ne cite aucune version de Python passe à côté d’un point concret : les deux dernières versions ont apporté des changements qui touchent directement le calcul scientifique et la data.
Python 3.14 est sorti le 7 octobre 2025. Son fait marquant est le free-threading, désormais officiellement supporté : le mode sans GIL, introduit expérimentalement en 3.13, devient un mode pris en charge — mais il reste opt-in, sous la forme d’une compilation dédiée du build free-threaded. Le surcoût en mono-thread est annoncé comme étant « de l’ordre de 5 à 10 %, selon la plateforme et le compilateur C utilisé » [1]. Pour la data, c’est une évolution de fond : le parallélisme en Python cesse d’être uniquement une affaire de processus.
Python 3.15 est en préparation. Le gel des fonctionnalités a eu lieu avec la bêta 1 le 7 mai 2026, la RC1 est sortie le 4 août 2026, la RC2 le 1er septembre 2026, et la sortie finale est prévue le 1er octobre 2026 [3]. Les nouveautés notables pour un profil data [2] :
| Nouveauté | Ce que ça change pour vous |
|---|---|
| Imports paresseux explicites (PEP 810) | Vous marquez une importation comme lazy et Python ne charge le module qu’au premier usage : démarrage plus rapide des scripts et des applications. |
| Profiler Tachyon (PEP 799) | Un profileur par échantillonnage, à surcoût quasi nul, adapté au diagnostic de performance en production. |
| UTF-8 par défaut (PEP 686) | Les entrées-sorties sans encodage explicite utilisent UTF-8 : moins d’erreurs de lecture de fichiers CSV texte. |
| Compilateur JIT amélioré | Le gain de performance annoncé par les benchmarks pyperformance est de 8 à 9 % sur x86-64 Linux, et de 12 à 13 % sur Apple silicon. |
| Stable ABI pour les builds free-threaded (PEP 803) | Une nouvelle ABI abi3t pour les extensions C : les paquets compilés doivent s’adapter, c’est le point de rupture à surveiller si vous dépendez de bibliothèques natives. |
En pratique : si vous démarrez aujourd’hui, installez Python 3.14 et suivez la sortie de 3.15 sans précipitation — attendez quelques semaines après la finale que l’écosystème data (NumPy, pandas, scikit-learn) ait publié ses roues compatibles.
SQL : interroger les bases de données
SQL est un outil-clé pour toute personne qui travaille avec des données. Il vous permet de dialoguer avec des bases de données relationnelles — un peu comme un langage pour poser des questions à un tableau géant. C’est aussi l’une des compétences les plus systématiquement demandées dans les offres d’emploi data, y compris pour des postes orientés Python.
Exemple — Vous voulez savoir combien de clients ont passé une commande en juillet 2026 ? Avec SQL, vous obtenez cette information en une seule ligne de requête.
Ce que vous devez savoir faire en SQL (au début) :
- Sélectionner des colonnes : afficher le prénom de tous les clients.
- Filtrer des lignes : voir uniquement les commandes supérieures à 100 €.
- Trier les données : du plus grand au plus petit.
- Faire des calculs simples : somme, moyenne, comptage.
- Croiser deux tables : relier les commandes aux clients qui les ont passées.
SQL est universel. Que vous travailliez dans une start-up ou une grande banque, vous aurez quasiment toujours affaire à des bases de données.
Astuce — Entraînez-vous gratuitement sur le tutoriel SQL de ThoughtSpot (ex-Mode Analytics), sans rien installer [22].
Étape 2 – Manipuler et visualiser les données
Une fois les bases posées, il est temps de passer à l’action. La Data Science, c’est surtout mettre les mains dans les données.
Nettoyer, transformer, structurer : bienvenue dans la data
Avant de construire des modèles, il faut comprendre les données et les rendre exploitables. C’est là qu’interviennent :
- Pandas (Python) : importer, nettoyer, transformer, grouper.
- Tidyverse (R) : l’équivalent R, très utilisé en recherche et analyse.
Exemple — Vous recevez un fichier de 10 000 lignes avec les ventes d’une boutique. Grâce à Pandas, vous filtrez uniquement les ventes de décembre, calculez la moyenne par région, et repérez les erreurs de saisie en quelques lignes de code.
Un conseil que je répète souvent en formation : la qualité du nettoyage détermine la qualité de tout ce qui suit. Un modèle entraîné sur des données mal préparées ne se rattrape pas au moment de l’évaluation.
Visualiser les données pour mieux décider
La visualisation est une étape clé pour comprendre ce qui se cache derrière les chiffres. Elle vous aide à repérer des tendances, détecter des anomalies et raconter une histoire avec vos données.
Outils principaux :
- Matplotlib & Seaborn (Python) : graphiques simples ou très personnalisés.
- ggplot2 (R) : visualisations élégantes, prêtes à publier.
- Plotly (Python/R) : graphiques interactifs, très efficaces pour les dashboards.
Exemple — Vous voulez montrer l’évolution mensuelle du chiffre d’affaires sur 3 ans. Un graphique Seaborn ou ggplot2 rend l’information immédiatement compréhensible, là où un tableau de chiffres demanderait plusieurs minutes d’analyse.
Conseil de pro — Ne vous précipitez pas sur les modèles. Prenez le temps de bien manipuler et visualiser vos données. C’est souvent là que naissent les meilleures idées et les vraies découvertes.
Étape 3 – Comprendre le machine learning
C’est le cœur de la Data Science moderne. Le machine learning (ou apprentissage automatique) permet de créer des modèles prédictifs : à partir de données passées, on anticipe des comportements futurs. Dit autrement : on apprend à l’ordinateur à reconnaître des motifs et à faire des prédictions.
Les grandes familles d’algorithmes
- Régression : prédire une valeur continue. Exemple : prévoir le chiffre d’affaires du mois prochain.
- Classification : trier des données dans des catégories. Exemple : un email est-il un spam ou non ?
- Clustering : regrouper automatiquement des éléments similaires. Exemple : segmenter des clients selon leur comportement d’achat.
Les outils pour commencer
- Scikit-learn (Python) : la boîte à outils la plus utilisée pour créer, tester et comparer des modèles.
- Caret / tidymodels (R) : l’équivalent dans l’univers R, très complet et bien documenté.
Exemple — Vous voulez prédire si un client risque de résilier son abonnement. Vous entraînez un modèle de classification avec Scikit-learn sur les données historiques, puis vous l’appliquez à vos nouveaux clients pour cibler vos actions de rétention.
Jeux de données pour s’entraîner
Pas besoin d’aller chercher loin : scikit-learn embarque plusieurs jeux de données de référence, dont deux parfaits pour débuter [19]. Et pour le reste, le catalogue Kaggle couvre à peu près tous les sujets [24].
| Objectif | Jeu de données | Où le trouver |
|---|---|---|
| Régression | California Housing — prévoir le prix de maisons | fourni avec scikit-learn via fetch_california_housing() [19] |
| Classification | Iris — prédire l’espèce d’une fleur | fourni avec scikit-learn via load_iris() [19] |
| Clustering | Mall Customers — segmenter des clients | sur Kaggle [25] |
Conseil de pro — Commencez simple. Ne cherchez pas à tout comprendre d’un coup. Et surtout : ne vous arrêtez pas au score. Essayez de comprendre ce que votre modèle apprend… et pourquoi il peut se tromper.
L’outillage : ce qui distingue un profil junior employable
C’est le plus grand manque des roadmaps d’apprentissage, et pourtant c’est ce qui se voit le plus vite sur un profil : savoir écrire une fonction ne suffit plus. Ce qui sépare un notebook d’un projet, c’est un environnement isolé, des dépendances reproductibles, un linter, des tests et du typage. Quatre outils suffisent pour couvrir l’essentiel.
Un environnement isolé et des dépendances reproductibles avec uv
Un environnement virtuel par projet, c’est la règle de base : il évite qu’un projet A casse un projet B en installant une version différente d’une bibliothèque. Longtemps, cela voulait dire jongler entre virtualenv, pip et un fichier de dépendances généré à la main.
uv simplifie tout cela. Sa documentation le présente comme « un outil unique pour remplacer pip, pip-tools, pipx, poetry, pyenv, twine, virtualenv, et plus encore » [4]. Concrètement :
uv init mon-projet        # crée le projet et son pyproject.toml
uv add pandas scikit-learn  # ajoute les dépendances et fige les versions
uv run analyse.py         # exécute le script dans l'environnement du projet
Le fichier de versions figées (uv.lock) permet à une autre personne — ou à vous dans six mois — de retrouver exactement les mêmes dépendances. C’est cette reproductibilité qui manque le plus souvent dans un premier portfolio.
Linter, tests et typage : ruff, pytest, mypy
Trois outils, trois problèmes différents :
- ruff — linter et formateur réunis dans un seul outil. Il repère les erreurs courantes et met votre code au format de façon cohérente [5]. Deux commandes suffisent pour commencer :
ruff check .etruff format .. - pytest — le cadre de tests de référence en Python. Une fonction qui commence par
test_est exécutée automatiquement, et une simple assertion Python suffit à exprimer ce qu’on attend [6]. - mypy — le vérificateur statique de types. Il analyse vos annotations sans exécuter le code et signale les incohérences avant l’exécution [7]. Lancez-le avec
mypy ..
Conseil de pro — N’attendez pas d’avoir un « gros » projet pour tester. Un test qui vérifie qu’une fonction de nettoyage renvoie bien le bon nombre de lignes est déjà un vrai test — et il vous fera gagner du temps dès la deuxième modification.
La nuance de gouvernance : Astral et OpenAI
Ces outils ne sortent pas de nulle part : uv et ruff sont développés par Astral, également à l’origine du vérificateur de types ty. Le 19 mars 2026, Astral a annoncé rejoindre OpenAI au sein de l’équipe Codex. L’entreprise indique que « OpenAI continuera de soutenir nos outils open source après la finalisation de l’accord » [8].
Est-ce un risque ? Les outils restent open source, donc forkables : même dans le scénario le plus défavorable, la communauté peut reprendre le flambeau. Mais le rythme de développement d’outils aussi centraux ne dépend plus d’un éditeur indépendant. C’est un sujet de débat légitime dans la communauté, et vous avez le droit d’en tenir compte — y compris en gardant venv et pip sur un projet où la stabilité prime sur la modernité de l’outillage.
Git et le workflow de contribution
Git est absent de la plupart des roadmaps débutantes, alors qu’il est non négociable en pratique : c’est le système de gestion de versions utilisé partout, et un recruteur regarde votre historique avant votre CV. La documentation officielle de Git est gratuite et traduite [9].
Les bases à maîtriser :
- Le dépôt :
git initpour démarrer,git clonepour récupérer un projet existant. - Les commits : enregistrer une étape de travail avec un message qui explique pourquoi, pas seulement quoi. Un historique lisible vaut mieux qu’un historique exhaustif.
- Les branches :
git switch -c ma-fonctionnalitepour travailler à l’écart de la branche principale sans la casser. - Le fichier README : ce que fait le projet, comment l’installer, comment l’exécuter. C’est la première chose qu’on lit de votre travail.
- Le fichier
.gitignore: pour ne pas versionner les données volumineuses, les environnements virtuels et les fichiers de sortie. Un dépôt propre, c’est un dépôt qu’on peut cloner et exécuter. - La pull request : proposer ses modifications, les faire relire, discuter avant de fusionner. C’est le mode de travail des équipes, et c’est aussi ce qui vous fera progresser le plus vite en revue de code.
Conseil de pro — Même en solo, travaillez par branches et ouvrez des pull requests sur vos propres projets. Le jour où vous rejoignez une équipe, ces réflexes sont déjà en place — et votre historique GitHub raconte une méthode de travail, pas seulement du code.
Étape 4 – Aller plus loin : deep learning, IA générative et cloud
Vous maîtrisez les bases, vous savez manipuler des données, construire des modèles… Vous êtes prêt·e à découvrir les outils les plus puissants de la Data Science moderne.
Deep Learning : l’intelligence artificielle à grande échelle
Le deep learning est une branche du machine learning, inspirée du fonctionnement du cerveau humain. Il est particulièrement utile pour la reconnaissance d’image, la traduction automatique, les assistants vocaux et l’analyse de textes (NLP). En 2026, il est aussi au cœur de l’IA générative — les grands modèles de langage actuels reposent sur ces architectures.
Les deux frameworks stars :
- TensorFlow : développé par Google, très utilisé en production.
- PyTorch : très largement adopté dans la recherche en IA, réputé plus intuitif et plus flexible. Plutôt qu’un chiffre de parts de marché — qui n’a rien de fiable pour 2026 — retenez ce constat d’usage : la majorité des articles de recherche et des modèles ouverts que vous croiserez publient leur code en PyTorch. Sa documentation officielle est le point de départ [23].
Exemple — Vous voulez créer un modèle qui détecte automatiquement des défauts sur des photos de produits ? Vous pouvez entraîner un réseau de neurones convolutif avec PyTorch.
Le deep learning demande souvent plus de ressources — temps, données, calculs. Vous n’avez pas besoin de le maîtriser dès le début. Mais si vous voulez travailler dans l’IA ou l’IA générative, c’est une compétence incontournable.
IA générative et LLM : la compétence qui a le plus bougé
En 2026, la maîtrise des grands modèles de langage (LLM) est devenue une compétence à part entière pour les Data Scientists. Savoir appeler une API — Claude (Anthropic), GPT-5 (OpenAI), Mistral… — pour automatiser des tâches d’analyse, de résumé ou de génération de code est aujourd’hui très recherché.
Les notions à connaître :
- Prompt engineering : rédiger des instructions claires pour obtenir de bons résultats.
- RAG (Retrieval-Augmented Generation) : combiner un LLM avec vos propres données.
- Agents IA : automatiser des workflows complexes avec des LLMs en orchestration.
Mais depuis 2025, ce n’est plus là que se joue la différence. Quatre sujets ont pris une importance décisive :
- L’évaluation (les evals). Construire un jeu de test représentatif de vos cas d’usage réels, et mesurer objectivement si une modification du prompt ou un changement de modèle améliore ou dégrade le résultat. Sans evals, vous ne pilotez rien : vous jugez à l’œil sur trois exemples.
- Les bases vectorielles. Stocker des représentations vectorielles de vos documents pour retrouver les passages pertinents : c’est la brique technique qui rend le RAG possible.
- Le Model Context Protocol (MCP). Un protocole ouvert qui standardise la façon dont un modèle accède à des outils et à des sources de données externes, au lieu de réécrire un connecteur pour chaque service [13].
- Le contexte long et le context engineering. Savoir ce qui mérite d’entrer dans la fenêtre de contexte, dans quel ordre, et à quel coût. C’est devenu un savoir-faire à part entière, distinct de la rédaction du prompt.
Ajoutez à cela une préoccupation très concrète, trop souvent découverte en production : le coût et la latence. Un appel de LLM se facture au token et se compte en secondes. Un système qui fonctionne sur dix requêtes de test peut devenir inexploitable sur dix mille — il faut donc mesurer, mettre en cache ce qui peut l’être, et choisir un modèle adapté à la tâche plutôt que le plus puissant par défaut.
Conseil de pro — Même sans expertise technique en deep learning, vous pouvez tirer parti des LLMs via leurs APIs Python. C’est une porte d’entrée concrète vers l’IA appliquée — et savoir mesurer ce qu’on obtient est ce qui vous distinguera.
Big Data & Cloud : travailler à l’échelle
Quand les jeux de données deviennent trop volumineux pour un simple ordinateur, il faut passer à l’échelle. C’est là qu’interviennent le Big Data et le Cloud.
- Apache Spark : traiter des millions de lignes en parallèle, via PySpark en Python.
- AWS, GCP, Azure : les trois grands fournisseurs cloud pour stocker vos données, entraîner vos modèles et déployer des applications à grande échelle.
Exemple — Vous voulez créer une API qui prédit la demande de produits selon la météo ? Vous pouvez héberger votre modèle sur GCP et l’appeler depuis votre site ou application.
Conseil de pro — Ne vous précipitez pas sur Spark ou le cloud. Ces outils sont puissants mais secondaires quand on débute. Revenez-y quand vous serez à l’aise avec les étapes précédentes.
MLOps : du notebook au modèle en production
C’est le premier écart entre « a fait des notebooks » et « recruté ». Un modèle qui vit dans un notebook ne sert à personne ; un modèle accessible par une API, traçable et reproductible, oui. Pas besoin de tout maîtriser pour commencer — quatre briques donnent une base sérieuse.
| Brique | Rôle | Point de départ |
|---|---|---|
| FastAPI | Exposer votre modèle derrière une API HTTP, avec une documentation interactive générée automatiquement | fastapi.tiangolo.com [10] |
| Docker | Empaqueter l’application et ses dépendances pour qu’elle tourne de la même façon sur votre machine et sur un serveur | docs.docker.com [28] |
| MLflow | Tracer vos expériences : quels paramètres, quelles métriques, quel artefact pour chaque exécution | mlflow.org [11] |
| DVC | Versionner les données et les modèles comme on versionne du code, sans les stocker dans Git | dvc.org [12] |
Conseil de pro — Un premier projet MLOps n’a pas besoin d’être ambitieux : un modèle simple, exposé par une petite API FastAPI, empaqueté dans une image Docker et dont les expériences sont tracées dans MLflow. Ce triptyque suffit à montrer que vous savez livrer, pas seulement entraîner.
IA responsable et cadre légal
Un dernier volet qu’aucune roadmap 2026 ne devrait ignorer : le cadre. Travailler avec des données et des modèles, c’est aussi respecter des règles — et ce n’est pas réservé aux juristes.
Le point le plus concret est la littératie IA. L’article 4 de l’AI Act européen impose aux fournisseurs comme aux utilisateurs de systèmes d’IA de prendre des mesures pour développer la littératie IA de leurs équipes. Cette obligation est entrée en application le 2 février 2025 [14] [15]. Autrement dit : ce n’est pas un sujet de veille lointain, cela concerne toute organisation qui déploie de l’IA, quelle que soit sa taille.
Les notions de base à connaître, même sans être juriste :
- Les données personnelles : ce que vous pouvez collecter, conserver, croiser — et ce que le RGPD interdit. Le hub de la CNIL sur l’intelligence artificielle est le point d’entrée francophone le plus fiable [16].
- Les usages interdits : l’AI Act prohibe certaines pratiques, notamment la notation sociale et certaines formes de surveillance.
- La transparence : informer les personnes qu’elles interagissent avec un système d’IA, et documenter les usages à risque.
- Les biais et l’équité : un modèle apprend ce que les données lui montrent. Évaluer les disparités de performance entre groupes fait partie du travail.
J’ai écrit un article dédié à ce sujet, plus complet : IA responsable en Data Science. Si vous ne devez lire qu’une seule section en plus de cette roadmap, c’est celle-là.
Étape 5 – Portfolio et mise en pratique
Apprendre la théorie, c’est bien. Mais pour progresser vraiment — et surtout pour trouver un emploi ou des missions — vous devez montrer ce que vous savez faire.
Pourquoi créer un portfolio ?
Votre portfolio est votre vitrine. Il permet de prouver que vous maîtrisez les compétences annoncées, de vous différencier des autres candidats, et de rassurer les recruteurs sur votre capacité à passer de la théorie à la pratique.
Comment construire un bon portfolio ?
Pas besoin de dizaines de projets. Mieux vaut en avoir 3 ou 4 bien choisis, qui montrent différentes facettes de votre profil :
- Analyse exploratoire : partez d’un jeu de données public (Airbnb, Netflix, météo…) et racontez une histoire en visualisant les données.
- Machine learning : entraînez un modèle de classification ou de régression sur un jeu simple.
- Dashboard interactif : créez une application web avec Streamlit (Python) ou Shiny (R).
- Projet IA générative : en 2026, ajouter un projet utilisant un LLM via API (résumé automatique, chatbot sur vos données, agent IA) est un vrai différenciateur.
- Projet déployé : un modèle exposé par une petite API et empaqueté dans un conteneur fait plus d’effet qu’un notebook de plus. C’est le lien direct avec la section MLOps ci-dessus.
- Cas réels : analysez vos propres données (dépenses, sport, musique Spotify…) ou aidez une association.
Astuce — Choisissez un thème qui vous inspire. Quand un projet vous amuse, vous irez beaucoup plus loin… et ça se verra dans la qualité du travail.
Où partager vos projets ?
- GitHub : hébergez votre code proprement, avec un README clair et un historique de commits lisible. Incontournable pour les recruteurs.
- Kaggle : participez à des compétitions ou publiez vos notebooks. Vous apprendrez énormément tout en vous constituant un profil public.
- Blog ou LinkedIn : expliquez ce que vous avez fait, comment, et pourquoi. Vulgariser votre travail montre que vous comprenez vraiment ce que vous faites.
Conseil de pro — Votre portfolio est vivant. Il évolue avec vous. Revenez dessus régulièrement, améliorez vos projets, supprimez ceux qui ne vous ressemblent plus. C’est aussi un moyen de prendre confiance en vous.
Ressources pour apprendre efficacement en 2026
- Formations vidéo : mes deux cours Udemy de 8h — R pour la Data Science et Python pour la Data Science.
- Livres : Python pour la Data Science (Éditions ENI) — le guide que j’aurais aimé avoir à mes débuts. Également : R pour la statistique et la science des données de François Husson, et le coffret SQL et bases de données pour progresser pas à pas.
- Pratique guidée : les micro-cours gratuits de Kaggle Learn — Python, Pandas, Data Visualization, Intro et Intermediate Machine Learning, Data Cleaning, Feature Engineering, Time Series, Geospatial, ML Explainability, Intro to Deep Learning, Computer Vision, NLP, Intro to AI Ethics et SQL [20]. Et TidyTuesday, un jeu de données proposé chaque semaine, à traiter en R ou en Python [21].
Jeux de données et exemples de portfolios
Deux familles de ressources, toutes gratuites et officielles :
| Type | Nom / description | Lien |
|---|---|---|
| Datasets | Catalogue Kaggle — tous niveaux, tous sujets | Kaggle [24] |
| Kaggle Learn — micro-cours gratuits et officiels, du Python au NLP | Kaggle Learn [20] | |
| TidyTuesday — un jeu de données par semaine, en R et en Python | TidyTuesday [21] | |
| Portfolios GitHub | Sajal Sharma — notebooks, ML, visualisation, dépôt régulièrement mis à jour | Sajal Sharma [26] |
| ShawhinT — un modèle de structure à adapter, pas un portfolio à copier | ShawhinT [27] |
Astuce — Regardez ces dépôts pour leur structure (organisation des dossiers, README, découpage des étapes), pas pour leur contenu. Votre valeur, c’est votre sujet et votre cheminement.
Conclusion – La Data Science est un chemin, pas une ligne droite
La Data Science en 2026, ce n’est pas juste une compétence technique. C’est un apprentissage vivant, un mélange de rigueur, de curiosité, et d’envie de comprendre le monde à travers les données. Il n’y a pas de parcours unique : vous pouvez venir des sciences, du marketing, de la littérature ou de l’art.
Ce qui compte, c’est d’avancer à votre rythme, avec une progression claire. Commencez par les bases, pratiquez régulièrement, outillez votre code, faites des projets qui vous parlent, et osez vous tromper. Vous apprendrez toujours quelque chose.
Pour situer les ordres de grandeur, à titre de retour d’expérience de formatrice : les personnes qui pratiquent régulièrement consolident les bases en six à douze mois, et comptent une à deux ans pour atteindre un niveau professionnel. Ce ne sont pas des garanties, seulement ce que j’observe — la bonne nouvelle, c’est que vous produisez des projets concrets bien avant la fin du parcours.
Ce n’est pas la vitesse qui compte, mais la constance.
Questions fréquentes
Combien de temps faut-il pour apprendre la Data Science en 2026 ?
À titre de retour d’expérience de formatrice — ce ne sont pas des garanties : les personnes qui pratiquent régulièrement consolident les bases en six à douze mois, et comptent une à deux ans pour atteindre un niveau professionnel. Le rythme dépend surtout de votre disponibilité et de vos acquis. La bonne nouvelle, c’est que vous produisez des projets concrets bien avant la fin du parcours.
Faut-il choisir Python ou R pour commencer la Data Science ?
Python est plus polyvalent — analyse, machine learning, web, IA générative — et c’est aujourd’hui le langage de référence pour appeler les APIs des grands modèles de langage. R est plus orienté statistiques et recherche académique, avec un écosystème de visualisation et de documents reproductibles très mature. Si vous hésitez, commencez par Python, puis explorez R plus tard : les deux sont complémentaires et de nombreux professionnels utilisent l’un ou l’autre selon les besoins.
Quelle version de Python installer en 2026 ?
Python 3.14, sorti le 7 octobre 2025, est le bon choix pour démarrer : il apporte le support officiel du free-threading (mode sans GIL), à activer par une compilation dédiée, avec un surcoût mono-thread annoncé de l’ordre de 5 à 10 %. Python 3.15 est en préparation, avec une sortie finale prévue le 1er octobre 2026 après les RC1 et RC2 d’août et septembre 2026 ; il apporte les imports paresseux explicites, le profileur Tachyon, UTF-8 par défaut et un JIT amélioré. Attendez quelques semaines après la finale que l’écosystème data publie ses paquets compatibles.
Pourquoi Quarto remplace-t-il R Markdown ?
Quarto est le successeur recommandé de R Markdown : il reprend le principe du document reproductible — texte, code et résultats dans un même fichier — en devenant langage-agnostique. La même syntaxe fonctionne pour R, Python, Julia ou Observable. R Markdown n’est pas déprécié et reste pris en charge, mais il ne reçoit plus d’initiatives de fonctionnalités majeures : le développement se poursuit du côté de Quarto.
Quels outils faut-il pour passer d’un script à un vrai projet Python ?
Quatre outils couvrent l’essentiel en 2026. uv, qui remplace pip, pip-tools, pipx, poetry, pyenv et virtualenv et gère un environnement isolé par projet à partir d’un pyproject.toml ; ruff, linter et formateur dans un seul outil ; pytest pour les tests ; et mypy pour la vérification statique des types. À signaler : le 19 mars 2026, OpenAI a annoncé l’acquisition d’Astral, l’éditeur d’uv et de Ruff — les outils restent open source, mais la gouvernance change, et c’est un sujet de débat légitime dans la communauté.
Pourquoi apprendre Git quand on débute en Data Science ?
Parce que Git est non négociable en pratique et qu’un recruteur regarde votre historique avant votre CV. Les bases à maîtriser sont le dépôt, les commits, les branches, le fichier README, le .gitignore et la pull request. Même en solo, travailler par branches et ouvrir des pull requests sur ses propres projets installe des réflexes qui seront déjà en place le jour où vous rejoindrez une équipe.
Faut-il apprendre le cloud et le Big Data dès le début ?
Non. Concentrez-vous d’abord sur la manipulation de données, les statistiques et le machine learning. Le cloud (AWS, GCP, Azure) et Spark viendront en complément quand vous voudrez déployer vos projets ou travailler sur de gros volumes. En revanche, une initiation au MLOps — exposer un modèle avec FastAPI, l’empaqueter avec Docker, tracer ses expériences avec MLflow — est un vrai différenciateur dès le premier portfolio.
Qu’est-ce que la littératie IA et pourquoi ça me concerne ?
L’article 4 de l’AI Act européen impose aux fournisseurs comme aux utilisateurs de systèmes d’IA de prendre des mesures pour développer la littératie IA de leurs équipes. Cette obligation est entrée en application le 2 février 2025 et concerne toute organisation qui déploie de l’IA, quelle que soit sa taille. Concrètement, cela veut dire comprendre ce que le système fait, quelles données il utilise, quels enjeux de protection des données il soulève et quels usages sont interdits.
Sources
- What’s new in Python 3.14Python Software Foundation
Notes de version officielles : Python 3.14 est sorti le 7 octobre 2025, et le free-threaded Python (PEP 779) y est officiellement supporté, sous forme de build dédié. Le surcoût en mono-thread y est chiffré : « The performance penalty on single-threaded code in free-threaded mode is now roughly 5-10%, depending on the platform and C compiler used. »
- What’s new in Python 3.15Python Software Foundation
Notes de la version 3.15 (documentation de la RC2) : imports paresseux explicites (PEP 810), profileur par échantillonnage Tachyon (PEP 799), UTF-8 par défaut indépendamment de l’environnement (PEP 686), nouvelle ABI stable abi3t pour les builds free-threaded (PEP 803), et JIT expérimental nettement amélioré — gain de 8-9 % en moyenne géométrique sur x86-64 Linux et de 12-13 % sur AArch64 macOS d’après les benchmarks pyperformance.
- PEP 790 — Python 3.15 Release SchedulePython Software Foundation
Calendrier officiel de la version 3.15 : gel des fonctionnalités à la bêta 1 le 7 mai 2026, RC1 le 4 août 2026, RC2 le 1er septembre 2026 et sortie finale prévue le 1er octobre 2026.
- uv — an extremely fast Python package and project managerAstral
Documentation officielle d’uv, présenté comme « a single tool to replace pip, pip-tools, pipx, poetry, pyenv, twine, virtualenv, and more ». Gestion d’un environnement par projet, dépendances déclarées dans pyproject.toml et versions figées dans un lockfile universel. Vérifie les commandes uv init, uv add, uv run et uv sync.
- Ruff — an extremely fast Python linter and code formatterAstral
Documentation officielle de Ruff, qui réunit lint et formatage dans un seul outil : ruff check pour le lint, ruff format pour le formatage, configurables depuis pyproject.toml.
- pytest documentationpytest
Documentation officielle de pytest : découverte automatique des tests, assertions Python natives et exécution d’une fonction de test par simple appel de la commande pytest, sans configuration initiale.
- mypy documentationmypy
Documentation officielle de mypy, vérificateur statique de types qui analyse les annotations sans exécuter le code et signale les incohérences avant l’exécution.
- Astral is joining OpenAIAstral
Annonce du 19 mars 2026 : Astral, l’éditeur d’uv, Ruff et ty, rejoint OpenAI au sein de l’équipe Codex. L’entreprise s’engage sur la continuité de l’open source — « OpenAI will continue supporting our open source tools after the deal closes » — et indique vouloir continuer à construire en public. Point de débat légitime sur la gouvernance de ces outils.
- Git — DocumentationGit
Documentation officielle de Git, gratuite et traduite : référence des commandes (init, clone, commit, branch, switch), du fichier .gitignore et des bases du travail collaboratif par branches et pull requests.
- FastAPIFastAPI
Documentation officielle de FastAPI, cadre Python pour exposer un modèle ou un service derrière une API HTTP, avec validation des données et documentation interactive générée automatiquement.
- MLflowMLflow (Linux Foundation)
Plateforme open source de suivi des expériences de machine learning : paramètres, métriques, artefacts et modèles associés à chaque exécution, pour rendre les résultats reproductibles.
- DVC — Data Version ControlDVC
Outil de versionnement des données et des modèles, conçu pour fonctionner avec Git sans stocker les fichiers volumineux dans le dépôt.
- Model Context ProtocolAnthropic
Spécification du Model Context Protocol, protocole ouvert qui standardise la façon dont les modèles de langage accèdent à des outils et à des sources de données externes, au lieu d’un connecteur spécifique par service.
- AI Act — Implementation TimelineFuture of Life Institute
Calendrier d’application du règlement européen sur l’IA : au 2 février 2025, « Prohibitions on certain AI systems and requirements on AI literacy start to apply ». Page mise à jour le 31 août 2026.
- Article 4 — AI literacyFuture of Life Institute
Texte de l’article 4 du règlement européen sur l’IA : les fournisseurs et les utilisateurs de systèmes d’IA doivent prendre des mesures pour développer la littératie IA de leurs équipes. Entrée en vigueur indiquée au 2 février 2025, visant aussi bien les fournisseurs que les déployeurs.
- Intelligence artificielle (IA)CNIL
Hub de la CNIL consacré à l’intelligence artificielle : enjeux de protection des données, fiches pratiques, glossaire et actualités. Point d’entrée francophone pour articuler un projet d’IA avec le RGPD.
- QuartoPosit
Documentation officielle de Quarto, système de publication scientifique et technique langage-agnostique : un même document peut exécuter du code R, Python, Julia ou Observable.
- Quarto — FAQ : R MarkdownPosit
Position officielle de l’équipe Quarto sur R Markdown : Quarto en est le successeur multiformat et multi-langage ; R Markdown reste pris en charge mais ne reçoit plus d’initiatives de fonctionnalités majeures.
- Real-world datasets — scikit-learnscikit-learn
Documentation des jeux de données fournis avec scikit-learn, dont California Housing (fetch_california_housing) et Iris (load_iris), utilisés comme exemples de régression et de classification dans l’article.
- Kaggle Learn — free micro-coursesKaggle
Micro-cours gratuits et officiels de Kaggle : Python, Pandas, Data Visualization, Intro et Intermediate Machine Learning, Data Cleaning, Feature Engineering, Time Series, Geospatial, ML Explainability, Intro to Deep Learning, Computer Vision, NLP, Intro to AI Ethics et SQL.
- TidyTuesdayR for Data Science (GitHub)
Projet hebdomadaire de traitement et de visualisation d’un jeu de données, ouvert à R comme à Python, avec les contributions de la communauté. Dépôt toujours actif.
- SQL tutorialThoughtSpot
Tutoriel SQL gratuit et sans installation, à pratiquer dans le navigateur. Anciennement hébergé sur mode.com, qui redirige désormais vers ce domaine après le rachat de Mode par ThoughtSpot.
- PyTorch documentationPyTorch Foundation
Documentation officielle de PyTorch. L’article s’appuie dessus pour présenter le framework comme un choix d’usage largement répandu dans la recherche en IA, sans avancer de chiffre de parts de marché pour 2026 — aucune donnée fiable n’a été trouvée sur ce point.
- Kaggle DatasetsKaggle
Catalogue de jeux de données de Kaggle, tous niveaux et tous sujets, pour s’entraîner sur des cas concrets.
- Mall CustomersKaggle
Jeu de données classique de segmentation de clientèle, utilisé dans l’article comme exemple d’exercice de clustering. Page vérifiée accessible.
- data-science-portfolio (Sajal Sharma)GitHub
Exemple de portfolio Data Science : notebooks d’analyse, projets de machine learning et de visualisation. Dépôt toujours actif (dernière mise à jour en 2026), cité pour sa structure.
- example-portfolio (ShawhinT)GitHub
Gabarit de portfolio Data Science hébergé sur GitHub Pages. Cité comme modèle de structure à adapter, pas comme portfolio à suivre : il sert à voir comment organiser dossiers et README.
- Docker documentationDocker
Documentation officielle de Docker, pour empaqueter une application et ses dépendances dans une image qui s’exécute de façon identique sur une machine de développement et sur un serveur.
Chiffres et affirmations vérifiés sur ces sources le .